こんにちは、タカムネ(@takamune_ai)です。
AIで生成した動画を見て、「この動作をさらに続けさせたい」「終わり方を微調整したい」と思ったことはないでしょうか?
個人的には、途中はいいんだけど終わり方が気に入らない動画が結構あって、終わり方を微調整したくなるんですよね。
そこで今回試したのが、SVI 2 Proを使った動画の延長です。
この記事では、既存動画を延長する方法に絞り、ComfyUIでの導入手順や設定方法、実際に試した結果を紹介します。
- この記事では、ComfyUIがすでにインストールされていることを前提としています。ComfyUI本体の導入方法は割愛し、SVI 2 Proの導入と動画延長の手順を解説します。
- 今回の検証では、アニメ調の短い動画を使用しました。
SVI 2 Proとは?
SVI 2 Proは、Wan2.2をベースに、短い動画を連続して生成することで長時間の動画制作を目指す技術です。1枚の画像から動画を生成するだけでなく、すでに存在する動画の続きを生成することもできます。
今回の検証では、元動画の人物や背景をできるだけ維持しながら、その後の動きを自然に生成できるかを確認しました。
SVI 2 Proの導入と必要なモデル・ワークフロー
使用するカスタムノードとワークフロー
今回使用したのは、GitHubで公開されている「ComfyUI-Wan-SVI2Pro-FLF」です。

このプロジェクトには、既存動画を読み込み、プロンプトなどを使って続きを生成するワークフローが用意されています。
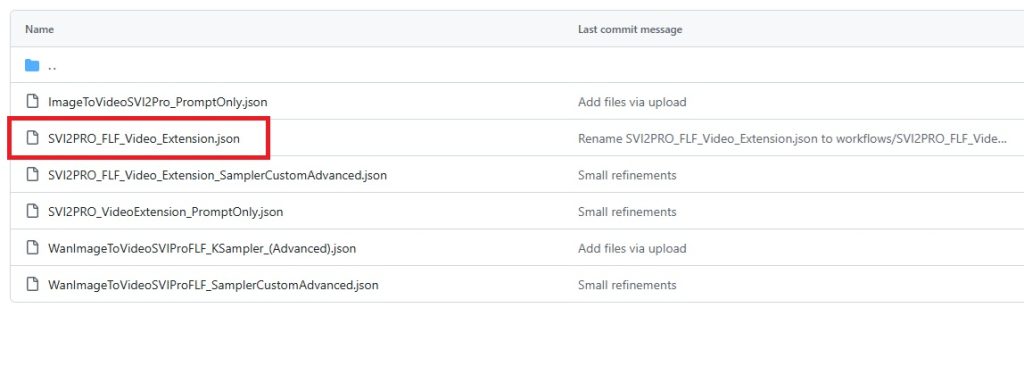
サイトのページ上部から「workflows」⇒「SVI2PRO_FLF_Video_Extension.json」をダウンロードします。
使用するモデル
今回、主に使用したのは、以下のQ8 GGUFモデルです。
- HIGH:
wan22EnhancedNSFWSVICamera_v2CAMI2VQ8HIGH.gguf - LOW:
wan22EnhancedNSFWSVICamera_v2CAMI2VQ8LOW.gguf
このモデルは、今回使うワークフローで推奨されていたモデルなので、まず無難にこれを試しました。先ほどのワークフロー配布のページにモデルのリンク先も掲載されています。
また、今回は、比較検証でWan2.2 I2V 14Bの標準FP16モデルも使用しました。これは必須ではありません。
- HIGH:
wan2.2_i2v_high_noise_14B_fp16.safetensors - LOW:
wan2.2_i2v_low_noise_14B_fp16.safetensors
なお、ワークフローで使用するVAE、テキストエンコーダー、SVI LoRAなども必要です。読み込んだワークフローで指定されているファイルを確認し、不足しているものを用意してください。
SVI 2 Proで既存動画を延長する手順
ここからは、既存の動画を読み込み、続きを生成するまでの操作を説明します。
1. ワークフローを読み込む
ダウンロードした動画延長用ワークフローをComfyUIで開きます。
ノードが赤く表示された場合は、必要なカスタムノードが不足している可能性があります。ComfyUI Managerなどで不足しているノードを確認してください。
モデル読み込みノードでは、ダウンロードしたHIGH・LOWモデルをそれぞれ指定します。
2. 延長したい動画を指定する
動画読み込みノードで、続きを生成したい動画ファイルを指定します。
元動画の終了部分を基準に続きを生成するため、人物の顔や姿勢、背景などが延長後もどの程度維持されるかが重要になります。
3. プロンプトを入力する
次に、延長部分で人物にどのような動きをさせたいか、プロンプトを指定します。
例えば、現在の姿勢を保ちながら自然な表情を続けさせたり、手を動かすなどの新しい動作を指示したりできます。
4. 生成設定を指定する
以下は、今回の検証で比較的良好な結果が得られた設定例です。まずはこの設定を参考にし、必要に応じて調整してください。
| 設定項目 | 設定値 |
|---|---|
| Frame Size | 0.80 |
| High Steps | 4 |
| Low Steps | 6 |
| SVI LoRa強度 | 0.8 |
| Length(追加生成されるフレーム数) | 41 |
| motion_latent_count | 1 |
| 出力FPS | 16 |
- この設定では、16fpsで約2.6秒分のフレームを追加生成します。
- Lengthは生成部分のフレーム数を指定する項目です。元動画と結合したあとの総フレーム数ではありません。
5. 動画を生成して確認する
設定が完了したら、ComfyUIの実行ボタンから生成を開始します。処理が終わると、元動画と生成した延長部分をつなげた動画を確認できます。
最初にチェックしたいのは、元動画が終わって延長部分に切り替わる瞬間です。
人物の位置や背景が急に変わっていないか、動きが不自然に途切れていないかを確認します。そのうえで、延長部分の表情や動作、画質を見ていきます。
実際に動画を延長した結果
ここからは、実際にSVI 2 Proで生成した動画を紹介します。今回目指したのは、以下の2点です。
- 元動画から違和感なく映像が続くこと
- プロンプトで指定した動きを自然に再現すること
ところが、実際に試してみると、この2つを同時に満たすのはかなり難しいことが分かりました。元素材の状況によると思うので一概には言えませんが、私は正直かなり苦労しました。
背景や衣装をきれいに維持できても、指示した動きが再現されないことがあります。反対に、指示どおりに動いても、不自然な残像が発生することもありました。
解像度や生成ステップ数、使用モデルなどを変更しながら試したので、以下にご紹介します。
検証環境
今回の動画生成は、以下のPC環境で行いました。
- CPU:AMD Ryzen 9 3900X 12-Core Processor
- GPU:NVIDIA GeForce RTX 4080(VRAM 16GB)
- メモリ:64GB
- 使用ソフト:ComfyUI
- 動画生成:Wan2.2/SVI 2 Pro
- 使用モデル:Q8 GGUF(検証用としてWan2.2 I2V 14B FP16)
元動画と延長後の動画を比較
まずは、今回使用した元動画をご覧ください。
- 元動画は、約5.8秒(92フレーム)のアニメ調の動画
- 解像度は、704×928(16fps)
- メガネをかけたメイドさんが、メガネのフレームを左手で触っている
- 常に正面を見ていて、そこまで動きは激しくないので、動画延長はやりやすい部類
続いて、この動画の続きをSVI 2 Proで生成した結果です。
- 今回は、41フレームを追加生成し、完成動画は約8.3秒(133フレーム)になった
- 元動画の続きとして、最後にメガネを外して下に下す動作をプロンプトで指示した
この動画の生成条件
今回の生成条件は次のとおりです。
- 使用モデル:Q8 GGUF(SVI-camera v2、HIGH/LOW)
- 生成解像度:800×1056
- HIGH側 Steps:4
- LOW側 Steps:6
- SVI LoRA強度:0.8
- Length:41フレーム
- motion_latent_count:1
- 元動画:92フレーム(約5.8秒)
- 完成動画:133フレーム(約8.3秒)
- 出力FPS:16
An adult woman in an elegant navy-blue maid dress and white frilled headdress remains facing the camera in the ornate interior. She continues naturally from the final frame of the source video, with her fingertips resting lightly at the rim of her glasses.
During the first half of the continuation, she holds almost the same pose and camera distance, making only tiny natural breathing motions and occasional gentle blinks. Her head stays nearly still, her expression remains soft and neutral.
During the second half of the continuation, she slowly and gently removes her glasses with the hand already touching the frame. She carefully pulls the glasses forward away from her face in one smooth, natural motion, then gradually lowers them toward her upper chest, holding them securely in the same hand. By the end of the video, her glasses are completely removed from her face and held visibly below her chin, near her upper chest. Her eyes are fully visible, and she gives a small, gentle smile.
The movement is calm, deliberate, and physically natural, with anatomically consistent fingers and hands. Her other hand remains relaxed and still. The glasses retain their original shape, thin rims, and proportions throughout the entire action.
Preserve the exact original anime illustration style and character identity, fine individual strands of dark hair, crisp layered white headdress ruffles, intricate scalloped white lace on the bodice, delicate seams and folds in the navy fabric, thin glasses rims, and the precise wallpaper pattern. Maintain consistent lighting, neutral color balance, stable sharpness, and consistent fine linework from the source.
No sudden movements, no repeated glasses-removal gesture, no extra hands or fingers, no disappearing or morphing glasses, no camera refocusing, no intentional depth-of-field changes.
Fully locked-off stationary camera: fixed position, angle, framing, focal length, and horizon; no pan, tilt, zoom, dolly, orbit, roll, rotation, or camera shake.
プロンプトは、「前半は眼鏡に指を添えた姿勢を維持し、後半でゆっくり眼鏡を外して下におろす動作」を指定しています。なお、これは、ChatGPTに出力してもらいました。
元動画とのつながり
今回の生成では、元動画に登場する人物の顔や衣装、背景の構図がおおむね維持され、比較的自然につながる結果になりました。
特に、背景の壁紙や装飾は大きく崩れず、元動画の雰囲気を保てています。
一方で、細部まで完全に同じというわけではありません。元動画と延長部分を比較すると、背景の質感や色合いにわずかな違いが見られる部分もありました。
これが、SVIで生成されることによって画質が落ちたのか、もともとの映像の雰囲気が引き継がれたのかは、はっきり判断できませんでした。
プロンプトの再現性
今回の生成では、比較的プロンプトに忠実に後半の延長部分でも動てくれました。実際にメガネを外しているのがわかると思います。
ただ、この例はうまくいったほうで、実際は全くプロンプトに従わない例もいくつかありました。Seed値によって反応が違ったりするので、多少のガチャ要素があるなという印象です。
解像度や生成フレーム数を変更した結果
前述したとおり、元動画と延長部分で若干の画質変化を感じたため、いくつか考えらえるパラメーターを変更してテストしてみました。
- Frame Size : 0.62 ⇒ 0.80
- Length : 41 ⇒ 81
Frame Sizeを上げると生成される動画の解像度が上がります。当然ながら動画全体の画質は上がって全体の印象はよくなるのですが、元動画と延長部分で画質変化が少なくなるか?というと微妙でした。0.80以上の数値も試しましたが、結果は同様。
また、Lengthを増やして、動画をより長く生成してもみましたが、81フレームを生成した場合は、より画質が変化するようになったという印象です。
Q8 GGUFとFP16では何が違ったか
検証として、標準のWan2.2 I2V 14B FP16モデルでも試してみました。
一般的にFP16の方が高性能という認識だったので、何らかの改善を期待していましたが、なぜか残像のような現象が発生しました。
- 動画の後半にかけて、残像が発生
- この現象は、Q8では起こらなかった
- 残像はかなり気になるが、FP16の方が背景のディティールなどが鮮明な印象
今回の検証で分かったこと
SVI 2 Proを使うことで、既存動画の続きを生成し、人物や背景を比較的自然につなげられることが分かりました。
ただし、元動画の見た目を維持することと、プロンプトどおりに動かすことを両立するのは簡単ではありませんでした。
今回の素材ではQ8 GGUFが比較的扱いやすく、FP16では背景の細部や動作指示の再現に優れた結果になった一方で、動きの内容によっては残像などの問題も発生しています。
動画延長は十分に実用性を感じられる一方、生成結果を確認しながら条件を調整する必要があると感じました。
動画延長がうまくいかないときの対処法
実際に動画を延長してみると、元動画とのつながりや画質、動作の再現に問題が生じることがあります。
今回の検証の結果からわかったこと、および、ワークフロー作者が案内している調整方法を紹介します。
動画の接続部分が不自然になる
元動画から延長部分に切り替わる瞬間に、映像が二重に見えたり、動きが飛んだりする場合があります。
使用したワークフローには、接続部分の重なりを調整する Image Batch Extend With Overlap ノードが用意されています。
ワークフロー作者は、接続部分に問題がある場合、overlap を1~2程度調整する方法を案内しています。
ただし、延長部分そのものの映像が崩れている場合は、接続位置の調整だけでは改善できません。
プロンプトで指定した動きをしてくれない
元動画の続きを生成できても、プロンプトで指示した動作が始まらないことがあります。
今回の検証でも、静かな姿勢を保つように指示したのに、人物が眼鏡を外す動作を始めたケースがありました。反対に、新しい動作を指示しても、元動画の動きをそのまま続ける場合があります。
ワークフロー作者は、指示が反映されない場合の方法として、生成フレーム数を81~101フレーム程度に増やすことや、動作をすぐに始めるようプロンプトを言い換えることを紹介しています。
また、私が検証したときには、Seed値による変化もあったので、Seedを変えて何回か試してみたほうがいいかもしれません。
まとめ
今回は、ComfyUIとSVI 2 Proを使用して、既存動画の続きを生成する方法を紹介しました。結論として、SVI 2 Proは、短いAI動画の続きを作りたいときに試す価値のある方法だと感じました。
FP16のほうが画質はよさそうなんですが、私の環境だと生成時間が長すぎるので、Q8 GGUFを使うのが無難だとという感想です。
SVI 2 Proは、1枚の画像から動画を生成することもできて、そちらのほうがメインの追加方のような気がするので、今度はそれを試してみたいと思います。
コメント